RuntimeWire clasifica nueve modelos de IA en investigación de noticias, resúmenes y redacción
GPT-6.1 Sol Pro lidera el índice de igual ponderación, que combina tres conjuntos de tareas con muestras que van de 50 a 100 tareas.
By Ryan Merket · Published · Updated
Primary source: RuntimeWire
Por qué importa
Un índice compuesto específico para salas de redacción puede ayudar a los equipos a comparar modelos en tareas editoriales, pero su ponderación igualitaria y el tamaño reducido de las muestras hacen que la clasificación sea un punto de partida, no una medida universal de la calidad del modelo.
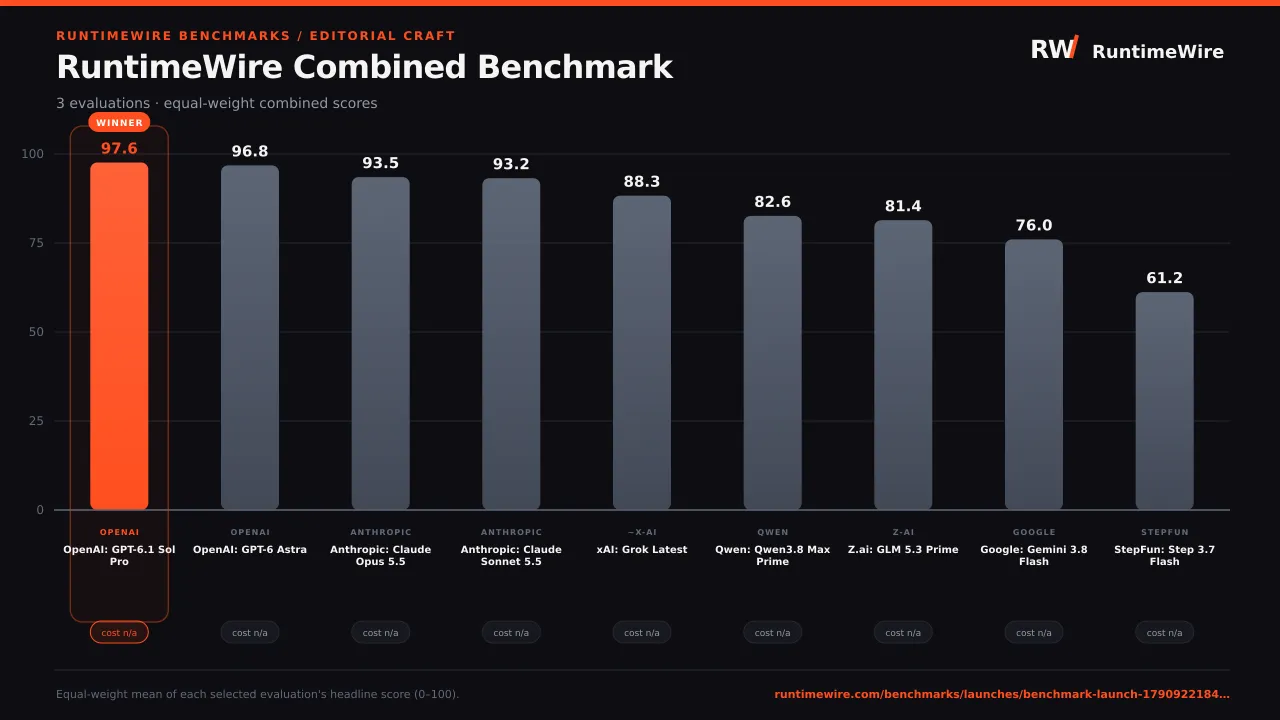
RuntimeWire ha publicado un leaderboard combinado que clasifica nueve modelos de IA en investigación periodística, resumen fundamentado y redacción de historias con restricciones, con OpenAI's GPT-6.1 Sol Pro en la cima con una puntuación de 97.6 de 100. El benchmark tardó 48 horas en completarse.…
When you purchase through links in our articles, we may earn a small commission. This doesn’t affect our editorial independence.