HeyGen 推出 Avatar V,以在更长的视频中保持 AI 克隆的可识别性
该模型使用 15 秒的录音来再现一个人的外貌和动作;HeyGen 对其领先逼真度的主张部分依赖于其自身的测试。
By Ryan Merket · Published · Updated
Primary source: HeyGen
为何重要
Avatar V 将 HeyGen 的宣传重点从生成会说话的肖像,转向在多次商业视频中维持一个可识别的人物形象。商业上的考验在于观众是否将这些生成的表演视为可信的交流,而不仅仅是模型是否在其制造商的基准测试中获胜。
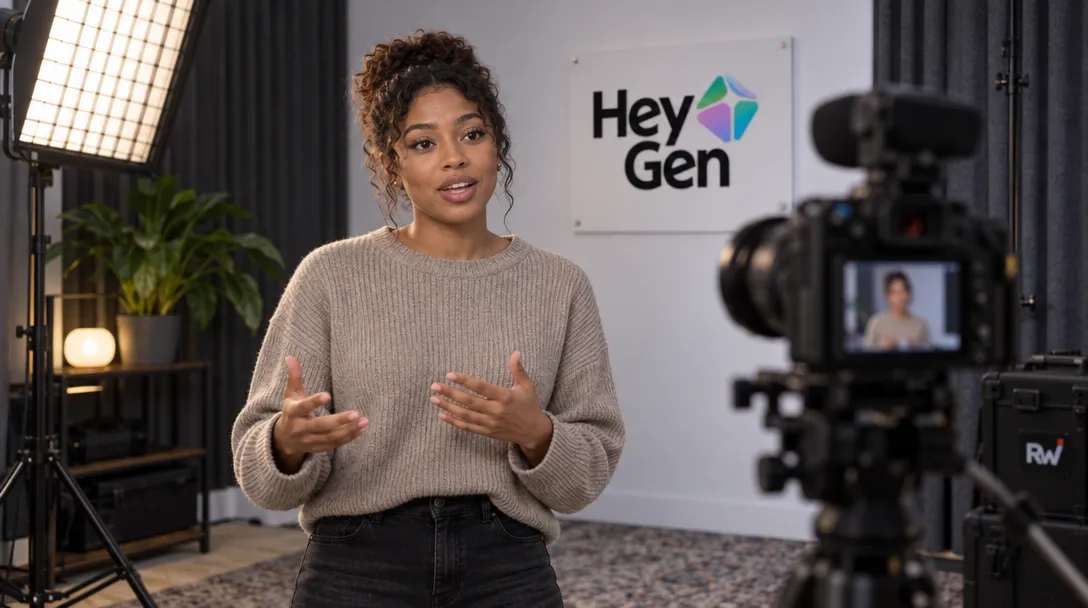
HeyGen's Avatar V 从一段 15 秒的录制生成视频,公司将其作为一种在不同场景、服装和更长脚本中保持人物肖像一致性的方式来推介。产品公告日期为 9 月 17 日,而非 10 月 10 日——后者是附在已流传用于该报道的图片 URL 上的日期。
对于 Joshua Xu (@joshua_xu_),HeyGen 的联合创始人兼首席执行官,这次发布延续了他早期在相机方面工作的一个赌注。Xu 在 Carnegie Mellon 学习计算机科学,并曾在 Snap 从事广告系统和计算摄影方面的工作。他曾将创办理念描述为替代相机:使用 AI 制作视频,而无需人们自己拍摄。这个新模型将这一前提出从让面部说话扩展到再现某个人的动作和表演方式。
身份即产品主张
Avatar V 从短视频参考中学习,HeyGen 表示该参考捕捉了手势、表情和举止。用户随后可以在不同环境和服装下生成一个演示者,而无需为每个版本重新录制。该产品面向诸如培训、产品演示和客户沟通等任务,公司可能希望在不再次预约拍摄的情况下更新视频。…
When you purchase through links in our articles, we may earn a small commission. This doesn’t affect our editorial independence.